
中小企業診断士 過去問
令和8年度(2026年)
問184 (経営情報システム 問24)
問題文
ある二値分類問題に対する2つの予測モデルAとBに対して、1,000件のデータを用いて性能評価を行ったところ、以下の混同行列が得られた。
モデルAとBの性能評価に関する以下の説明文の空欄①~④に入る語句の組み合わせとして、最も適切なものを下記の選択肢から選べ。ただし、適合率、再現率、F値は、次のように定義される。
・適合率:陽性と予測した件数のうち、実際も陽性である割合
・再現率:実際に陽性である件数のうち、陽性と予測した割合
・F値:2✕適合率✕再現率÷(適合率+再現率)で計算される値
[説明文]
モデルAとモデルBを比較したとき、適合率が大きいのは( ① )である。また、再現率が大きいのは( ② )である。一方、( ③ )を意味するF値が大きいのは( ④ )である。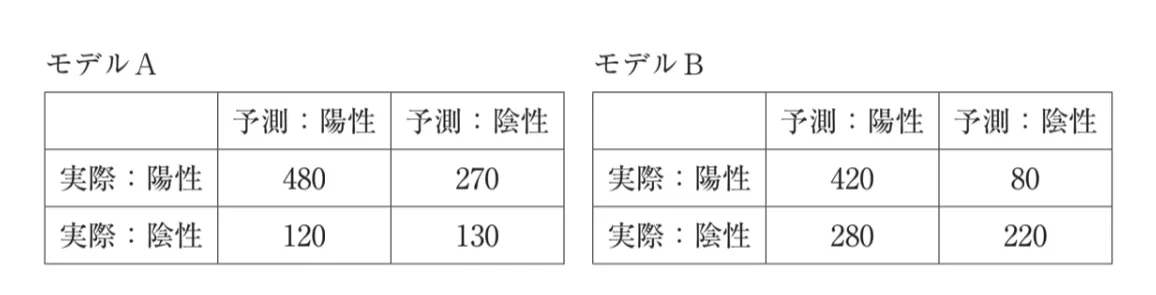
モデルAとBの性能評価に関する以下の説明文の空欄①~④に入る語句の組み合わせとして、最も適切なものを下記の選択肢から選べ。ただし、適合率、再現率、F値は、次のように定義される。
・適合率:陽性と予測した件数のうち、実際も陽性である割合
・再現率:実際に陽性である件数のうち、陽性と予測した割合
・F値:2✕適合率✕再現率÷(適合率+再現率)で計算される値
[説明文]
モデルAとモデルBを比較したとき、適合率が大きいのは( ① )である。また、再現率が大きいのは( ② )である。一方、( ③ )を意味するF値が大きいのは( ④ )である。
このページは閲覧用ページです。
履歴を残すには、 「新しく出題する(ここをクリック)」 をご利用ください。
問題
反映中…
中小企業診断士試験 令和8年度(2026年) 問184(経営情報システム 問24) (訂正依頼・報告はこちら)
ある二値分類問題に対する2つの予測モデルAとBに対して、1,000件のデータを用いて性能評価を行ったところ、以下の混同行列が得られた。
モデルAとBの性能評価に関する以下の説明文の空欄①~④に入る語句の組み合わせとして、最も適切なものを下記の選択肢から選べ。ただし、適合率、再現率、F値は、次のように定義される。
・適合率:陽性と予測した件数のうち、実際も陽性である割合
・再現率:実際に陽性である件数のうち、陽性と予測した割合
・F値:2✕適合率✕再現率÷(適合率+再現率)で計算される値
[説明文]
モデルAとモデルBを比較したとき、適合率が大きいのは( ① )である。また、再現率が大きいのは( ② )である。一方、( ③ )を意味するF値が大きいのは( ④ )である。
モデルAとBの性能評価に関する以下の説明文の空欄①~④に入る語句の組み合わせとして、最も適切なものを下記の選択肢から選べ。ただし、適合率、再現率、F値は、次のように定義される。
・適合率:陽性と予測した件数のうち、実際も陽性である割合
・再現率:実際に陽性である件数のうち、陽性と予測した割合
・F値:2✕適合率✕再現率÷(適合率+再現率)で計算される値
[説明文]
モデルAとモデルBを比較したとき、適合率が大きいのは( ① )である。また、再現率が大きいのは( ② )である。一方、( ③ )を意味するF値が大きいのは( ④ )である。
- ①:モデルA ②:モデルA ③:幾何平均 ④:モデルB
- ①:モデルA ②:モデルB ③:調和平均 ④:モデルA
- ①:モデルA ②:モデルB ③:調和平均 ④:モデルB
- ①:モデルB ②:モデルA ③:調和平均 ④:モデルA
- ①:モデルB ②:モデルA ③:幾何平均 ④:モデルB
正解!素晴らしいです
残念...
画像拡大
この過去問の解説 (2件)
01
「①:モデルA ②:モデルB ③:調和平均 ④:モデルA」の組み合わせが当てはまります。
この問題では、適合率、再現率、F値という3つの指標を使って、予測モデルAとモデルBの性能を比較します。
適合率は、陽性と予測したものがどれだけ正しかったかを表します。
再現率は、実際に陽性だったものをどれだけ見逃さずに発見できたかを表します。
F値は、適合率と再現率の調和平均であり、2つの指標をバランスよく評価するために使われます。
図の混同行列から計算すると、次の結果になります。
モデルA:適合率0.80、再現率0.64、F値約0.711
モデルB:適合率0.60、再現率0.84、F値0.700
したがって、適合率はモデルA、再現率はモデルB、F値はモデルAの方が大きくなります。
・計算の流れ
<混同行列の見方>
混同行列とは、モデルの予測結果と実際の結果を比較し、正しく予測できた件数や間違えた件数を整理したものです。
混同行列には、次の4つの分類があります。
真陽性(TP)
実際に陽性で、モデルも陽性と予測した件数です。
偽陽性(FP)
実際は陰性なのに、モデルが陽性と予測した件数です。
偽陰性(FN)
実際は陽性なのに、モデルが陰性と予測した件数です。
真陰性(TN)
実際に陰性で、モデルも陰性と予測した件数です。
適合率、再現率、F値の計算には、主にTP、FP、FNを使用します。
<モデルAの計算>
図の混同行列から、モデルAの件数は次のようになります。
真陽性(TP):480件
偽陽性(FP):120件
偽陰性(FN):270件
真陰性(TN):130件
<適合率>
適合率は、陽性と予測した件数のうち、実際に陽性だった割合です。
計算式は、
適合率=TP÷(TP+FP)
です。
モデルAの場合、
480÷(480+120)
=480÷600
=0.80
となります。
したがって、モデルAの適合率は0.80(80%)です。
<再現率>
再現率は、実際に陽性だった件数のうち、陽性と予測できた割合です。
計算式は、
再現率=TP÷(TP+FN)
です。
モデルAの場合、
480÷(480+270)
=480÷750
=0.64
となります。
したがって、モデルAの再現率は0.64(64%)です。
<F値>
F値は、適合率と再現率の調和平均です。
計算式は、
F値=2×適合率×再現率÷(適合率+再現率)
です。
モデルAの場合、
2×0.80×0.64÷(0.80+0.64)
=1.024÷1.44
=約0.711
となります。
したがって、モデルAのF値は約0.711です。
<モデルBの計算>
図の混同行列から、モデルBの件数は次のようになります。
真陽性(TP):420件
偽陽性(FP):280件
偽陰性(FN):80件
真陰性(TN):220件
<適合率>
420÷(420+280)
=420÷700
=0.60
したがって、モデルBの適合率は0.60(60%)です。
<再現率>
420÷(420+80)
=420÷500
=0.84
したがって、モデルBの再現率は0.84(84%)です。
<F値>
2×0.60×0.84÷(0.60+0.84)
=1.008÷1.44
=0.700
したがって、モデルBのF値は0.700です。
<①~④の比較>
①:適合率が大きいモデル
モデルA:0.80
モデルB:0.60
0.80の方が大きいため、①は「モデルA」です。
②:再現率が大きいモデル
モデルA:0.64
モデルB:0.84
0.84の方が大きいため、②は「モデルB」です。
③:F値が表す平均
F値は、適合率と再現率の調和平均です。
したがって、③は「調和平均」です。
④:F値が大きいモデル
モデルA:約0.711
モデルB:0.700
約0.711の方が大きいため、④は「モデルA」です。
適切です。
適合率はモデルAの0.80が大きく、再現率はモデルBの0.84が大きくなります。
また、F値は適合率と再現率の調和平均です。
F値を比較すると、モデルAが約0.711、モデルBが0.700となるため、モデルAの方が大きくなります。
したがって、すべての組み合わせが一致しています。
二値分類モデルの性能を評価する主な指標は、次のように整理できます。
<適合率(Precision)>
陽性と予測した件数のうち、実際に陽性だった割合です。
適合率=TP÷(TP+FP)
陽性と予測した結果の正確さを表します。
<再現率(Recall)>
実際に陽性だった件数のうち、陽性と予測できた割合です。
再現率=TP÷(TP+FN)
実際の陽性をどれだけ見逃さずに発見できたかを表します。
<F値(F1スコア)>
適合率と再現率の調和平均です。
F値=2×適合率×再現率÷(適合率+再現率)
適合率と再現率の両方を考慮し、バランスよく評価するための指標です。
今回の計算結果は、次のとおりです。
モデルA:適合率0.80、再現率0.64、F値約0.711
モデルB:適合率0.60、再現率0.84、F値0.700
この問題では、適合率と再現率では優れているモデルが異なっていても、F値で比較するとどちらが大きいかを判断できることがポイントです。
また、F値は幾何平均ではなく、調和平均であることも覚えておきましょう。
したがって、「①:モデルA ②:モデルB ③:調和平均 ④:モデルA」が最も適切です。
参考になった数2
この解説の修正を提案する
02
二値分類問題の性能評価に関する問題です。一見したところ難解そうに思えますが、定義の中に計算式が示されているため、その通りに計算すれば①②は正答できます。
・適合率:陽性と予測した件数のうち、実際も陽性である割合
→「予測:陽性」の縦の列を足して、「実際:陽性」の数字で割る。
モデルAは、480÷(480+120)=480÷600=0.80と求まります。
モデルBは、420÷(420+280)=420÷700=0.60と求まります。
以上から、モデルAとモデルBを比較したとき、適合率が大きいのはモデルAです。
・再現率:実際に陽性である件数のうち、陽性と予測した割合
→「実際:陽性」の横の行を足して、「予測:陽性」の数字で割る。
モデルAは、480÷(480+270)=480÷750=0.64と求まります。
モデルBは、420÷(420+80)=420÷500=0.84と求まります。
以上から、モデルAとモデルBを比較したとき、再現率が大きいのはモデルBです。
この時点で選択肢は2つに絞り込まれますが、空欄③④のF値が厄介です。F値とは、適合率と再現率のバランスを評価する指標です。「適合率と再現率のバランスを評価する」ので、モデルAとモデルBの表を見比べてバランスが良さそう(F値が大きい)なのはモデルA(空欄④)であることがすぐに分かります。ここで選択肢が1つに絞り込まれるため、空欄③は分からなくても正答できます。
※試験時間の制限があることを考えると、実際に計算して③④の正誤判断をすることは避けなければなりません。試験中に最も意識しなければならないことは、計算の速さや正確さもさることながら制限時間内でいかに科目合格点(60点)を確保するかの「タイムマネジメント」です。
以上から、空欄①~④に入る最も適切な語句の組み合わせは「①:モデルA ②:モデルB ③:調和平均 ④:モデルA」となります。
冒頭の解説より、「①:モデルA ②:モデルB ③:調和平均 ④:モデルA」であるため不適切な選択肢となります。
冒頭の解説より、空欄①~④に入る最も適切な語句の組み合わせは「①:モデルA ②:モデルB ③:調和平均 ④:モデルA」であるため正解の選択肢となります。
冒頭の解説より、「①:モデルA ②:モデルB ③:調和平均 ④:モデルA」であるため不適切な選択肢となります。
冒頭の解説より、「①:モデルA ②:モデルB ③:調和平均 ④:モデルA」であるため不適切な選択肢となります。
冒頭の解説より、「①:モデルA ②:モデルB ③:調和平均 ④:モデルA」であるため不適切な選択肢となります。
【補足】
実際にF値を計算して確認しなければ気が済まない人もいると思いますので、以下に計算式を挙げておきます。
2×(適合率×再現率)÷(適合率+再現率)
分子は掛け算、分母は足し算となっており、ここだけで十分に間違えそうです。また、統計がメインの試験ではないので、この計算式を使うような出題が毎年あるわけでもありません。つまり、この計算式を覚えようとすることは中小企業診断士試験においては考慮する必要がありません。
参考になった数0
この解説の修正を提案する
前の問題(問183)へ
令和8年度(2026年) 問題一覧
次の問題(問185)へ